2016/02/16
Blog wird auf Eis gelegt
Aufgrund geringer Nachfrage und weil ich momentan mit einem privaten Projekt in der Freizeit einigermaßen ausgelastet bin (-> Steyr-Werke), wird der Blog vorläufig geschlossen.

2015/10/25
Google Cloud Datalab
Google hat ein neues Service in seiner Cloud Platform am Start. Es heißt Google Cloud Datalab, ist noch im Beta-Stadium und setzt auf Jupyter und dem PyData Stack auf. Hier mein erster Eindruck bei einem kurzen Test.
PyData Stack auf Cloud Platform
Das aufsetzen des Datalabs erfolgt automatisiert, dauert aber seine Zeit (rund 10 min lt. Notification). Es wird eigenartigerweise als Google App Engine Anwendung erstellt und nicht, wie man meinen könnte, als Compute Engine Projekt. Standardmäßig läuft es aktuell auf einer n1-standard-1 Maschine (1 Kern, 3.75GB RAM) mit einem 100GB Laufwerk. Weitere Maschinen und Laufwerke können in den Verbund eingehängt werden, wenn mehr Rechenleistung bzw. Speicherkapazität nötig ist. Die Einbindung der Google-eigenen Storage Dienste ist natürlich unkompliziert möglich und auch sinnvoll - neben der Skalierbarkeit der Infrastruktur mEn. der Hauptgrund warum es sich überhaupt nachzudenken lohnt, die Analysen in die Google Cloud auszulagern. Der Preis für das Service ist aktuell (im Beta-Stadium) noch überschaubar. Man zahlt für die im Projekt verwendete Infrastruktur (Instanzen) und Services (zB. BigQuery), das Datalab ansich ist (noch) kostenlos - was sich möglicherweise nach dem Beta-Stadium ändern wird.
 |
| Jupyter Notebook: Anomaly Detection Beispiel |
Das Interface für das Datalab ist ein Jupyter Notebook (siehe Bild). Die essentiellen Bibliotheken aus dem PyData Stack sind vorinstalliert und müssen nur mehr bei Bedarf importiert werden. Das Notebook kann genauso wie bei einer lokalen Installation benutzt werden. Auch die interaktiven Visualisierungsfähigkeiten, wie man es von lokalen Notebooks kennt, sind in der Cloud auf selben Wege zu realisieren. Neben bisschen Dokumentation und Tutorials für das Verwenden des Notebooks und Einbinden von Storage Diensten, werden auch einige Beispiele standardmäßig im Home Ordner zur Verfügung gestellt. Das Bild ist beispielsweise aus dem Anomalie-Erkennungs-Beispiel.
Grundsätzlich ist mMn. das Google Cloud Datalab ein attraktives Angebot, um Datenanalysen und -visualisierungen in der Cloud mit dem PyData Stack durchzuführen, da man sich einiges an Installations- und Netzwerkadministrationsaufwand sparen kann. Interssant wird natürlich wie die Preisgestaltung dann im Alpha-Stadium sein wird. Vor allem für Data Science Teams, die nicht an einem Standort gemeinsam arbeiten, ist das Datalab eine überlegenswerte Möglichkeit. An einem Einsatz im Unternehmen (zumindest wenn es seinen Sitz in der EU hat) ist derzeit aber noch nicht zu denken. Das liegt aber weniger an der bewährten Technologie aus dem Python Ökosystem selbst, sondern eher an der rechtlichen Situation derzeit in Europa. Die zentrale Instanz wird nämlich in der US Central Region ausgeführt, was eine Verwendung durch europäische Unternehmen im operativen Einsatz derzeit leider unmöglich macht. Auch das sollte nach dem Beta-Stadium gelöst sein und die Region frei wählbar sein.
2015/08/05
MOOC Scalable ML
Der zweite Data Science MOOC unter Verwendung von Apache Spark ist jetzt auch zu Ende gegangen. Wie schon im letzten Post erwähnt, handelt er von skalierbaren maschinellem Lernen. Obwohl die sinnvolle Vertiefung zum Kurs "Introduction to Big Data with Apache Spark", konnte dieser MOOC nicht mal annähernd an dessen Qualität anschliessen.
Theorie
Der Vortrag über die vorgestellten Methoden (im Grunde waren das nur Lineare und Logistische Regression und Faktorenanalyse) war wirklich miserabel. Die Konzepte dahinter wurden, wenn überhaupt, nur kurz erwähnt und auch die Skalierbarkeit kam viel zu kurz. Dafür wurde mit Formeln um sich geworfen und Matrix-Rechenoperationen bis zum Exzess praktiziert. Natürlich auch wichtig, aber wenn schon nur so wenige Methoden vorstellt werden, hätten die zumindest auch leichter verständlich und mit ein paar Beispielen aus der Praxis präsentiert werden können. Der einzige Lichtblick war die Woche 2 - das lag aber nur daran, dass darin in Apache Spark eingeführt wurde und nämlich mit Vorträgen aus dem Vorgängerkurs "Introduction to Big Data with Apache Spark" (für Absolventen wie mich also eine Woche zum überspringen).
Praxis
Die praktisch ausgerichteten Labs waren zwar um Welten besser als die Vorträge, aber auch diese konnten mein Frustrationslevel bezüglich diesem Kurses nicht großartig senken. Man merkte zwar, dass die Ersteller aus den Fehlern der ersten Labs im Vorgänger-MOOC gelernt haben, es schlichen sich jedoch dennoch einige didaktische Fehler ein. Es ist z.B. mühsam, wenn ein Fehler am Ende des Labs auftritt, weil eine Funktion am Anfang nicht gestimmt hat (obwohl ursprünglich damit alle Test einwandfrei liefen) - so geschehen im Lab 4. Alles in Allem ein MOOC den man sich getrost sparen kann, um Zeit und Energie für bessere Lehrmaterialien aufzuwenden.
2015/07/04
MOOC über Big Data & Apache Spark - Teil 3
...Fortsetzung von Teil 2...
Die letzten beiden Wochen des MOOCs sind nun vorbei. Das vorgetragene Material in der vierten Woche handelte von Exploration und Datenqualität. Zwei Themen, die mMn in einer früheren Phase des Kurses besser aufgehoben gewesen wären. Der Inhalt beschränkte sich auch sehr auf Oberflächlichkeiten der beiden Bereiche. Hätte einiges an Zeit gespart, die Videos zu überspringen. Auch das Lab in dieser Woche hätte besser aufbereitet werden können. Die Fragestellung war zwar spannend -Text Analyse auf Produkt-Datensätze von Google und Amazon anwenden -, die Anleitung war aber großteils schwer verständlich und der vorgegebene Lösungsweg mühsam nachzuvollziehen. Die vorgegebenen Hilfsfunktionen, die mit wenig Code zu ergänzen waren, kosteten im Endeffekt mehr Zeit und Nerven, als wenn die komplette Programmlogik neu geschrieben hätte werden müssen. Dieses Lab kostete mir auch die Möglichkeit, 100% der Punkte für den Kurs zu bekommen, da ich die eine Hilfsfunktion bei Frage 4f nicht vor dem Ende der Soft-Deadline lösen konnte. Als ich die Lösung dann endlich hatte, wurden wegen der verspäteten Abgabe Strafpunkte abgezogen. Ein A wird sich dennoch ausgehen ;)
Die fünfte Woche war dann wieder entspannter. Sie bestand nur mehr aus dem letzen Lab des Kurses, das als Übergang zum kommenden MOOC von BerkeleyX, Scalable Machine Learning, gesehen werden kann. Das Lehrmaterial war wieder auf gewohnt hohem didaktischen Niveau und war wirklich lehrreich & spannend. Es ging um die Möglichkeiten mit Spark Maschinelles Lernen umzusetzen, was Dank dessen MLLib Bibliothek auch kein Hexenwerk (nichtmal auf verteilten Systemen) ist. Die Aufgabe beinhaltete, basierend auf einer Teilmenge von Filmbewertungen von MovieLens, ein Vorhersagemodell für Bewertungen, auf Basis von Collaborative Filtering, zu bauen. Am Schluß konnte man ein paar Filme selbst bewerten und erhielt dann eine Vorhersage für jene 20 Filme, die das Modell vorhersagt, dass sie einem am besten gefallen werden (also, dass man sie am besten bewerten wird). Basierend auf nur 10 Filme, die ich in der Aufgabe bewertet habe, waren meine Ergebnisse verblüffend treffsicher (eingedenk der limitierten Daten und Feature Basis):
 |
| Ergebnisse von meinem Modell |
Die mir bekannten Filme aus der Liste, würde ich tatsächlich alle sehr hoch bewerten. Von einigen habe ich die Story auf Wikipedia gesucht - und sollten mir eigentlich auch zusagen. Somit hatte der MOOC einen zusätzlichen Bonus, nämlich die Einsicht, dass ich mir mal Citizen Kane anschauen sollte ;)
Zusammenfassung
Da der MOOC nun beendet ist, ein kurzes Resümee. Abgesehen von kleineren Schwächen in Woche 4, war "Introduction to Big Data with Apache Spark" ein sehr gut gemachter Kurs. Ich würde sogar sagen, der beste MOOC, den ich bislang -egal auf welcher Plattform- belegt habe. Der vorgetragene Inhalt wurde verständlich aufbereitet und die praktischen Aufgaben hatten definitiv Realitätsbezug - kamen also nicht aus den typischen "Data Science"- und "Machine Learning"-Schubladen wie bei so vielen anderen Lehrmaterialien, die in der Fachliteratur zu finden sind. Im Grunde war das Durcharbeiten des Materials des Kurses sogar lehrreicher als die beiden von mir glesenen Bücher über Spark (Learning Spark: Lightning-Fast Big Data Analysis bzw. Advanced Analytics with Spark: Patterns for Learning from Data at Scale). Insofern freue ich mich jetzt schon sehr auf den kommenden Kurs von BerkeleyX auf edX über Maschinelles Lernen mit Spark, der jetzt auch schon gestartet ist. Praktisch dabei, dass Teile von "Introduction to Big Data with Apache Spark" auch wiederverwendet werden können. Man erspart sich somit eine neue virtuelle Maschine herunter zu laden und das Material der zweiten Woche ist aus dem vorhergegangen MOOC übernommen (inkl. des LABs). Über die Erfahrungen bei diesem MOOC werde ich dann auch die nächsten Wochen mal berichten.
2015/06/18
MOOC über Big Data & Apache Spark - Teil 2
...Fortsetzung von Teil 1...
3. Woche - Datenstrukturen
In dieser Woche ging es um Datenmanagement. Die beiden Lektionen handelten von strukturierten bzw. semi-strukturierten Daten. Auch die Performance beim IO unterschiedlicher Dateiarten wurde angesprochen.
Lektion 5, über semi-strukturierte Daten, handelte vor allem um tabellarische Strukturen und dem Zusammenspiel von Pandas Dataframes mit Spark. Als Beispiel wurden Server-Log-File Analysen angesprochen und an einer solchen, konnte man sich dann auch im Lab gleich selbst versuchen - konkret an den monatlichen HTTP Requests an einem Server der NASA. Der Schwierigkeitsgrad der Aufgaben wurde schon deutlich erhöht, dafür waren die Aufgabenstellungen auch ganz interessant, weil realitätsnah.
Die zweite Lektion der Woche handelte von strukturierten Daten. Das war dann natürlich sehr SQL-lastig und alle möglichen joins mit Spark RDD's wurden vorgestellt.
...to be continued...
2015/06/08
MOOC über Big Data & Apache Spark - Teil 1
In diesem Monat war es endlich so weit und der erste von zwei angekündigten MOOCs über Apache Spark wurde auf edX veröffentlicht. Ersterer hat den Titel "Introduction to Big Data with Apache Spark" und meine Erfahrungen dabei werde ich hier teilen. Der Zweite handelt von Maschinellem Lernen mit Spark und wird Ende des Monats starten. Da ich mich in letzter Zeit öfter mal nebenbei mit Spark zu Weiterbildungszwecken beschäftigt habe (Learning Spark: Lightning-Fast Big Data Analysis gelesen und Advanced Analytics with Spark: Patterns for Learning from Data at Scale gerade durcharbeite), passen die MOOCs da auch gerade gut dazu.
gelesen und Advanced Analytics with Spark: Patterns for Learning from Data at Scale gerade durcharbeite), passen die MOOCs da auch gerade gut dazu.1. Woche - Introduction
Der Einführungskurs in Big Data Analyse und Spark ist letzte Woche gestartet und soll 5 Wochen lange dauern. In Beispielen der Lektionen und Programmieraufgaben wird PySpark (die Python-API von Spark) anstatt Scala verwendet.
In den beiden ersten Lektionen ging es darum, Verständnis zu schaffen, was Big Data ist und welche datenwissenschaftliche Methoden es gibt. Der Inhalt in den Lektionen ist klar strukturiert und wird von Anthony D. Joseph verständlich präsentiert. Da es sich um eine Einführung handelt und die Themen generell komplex und unklar abgegrenzt sind, bleibt es verständlicherweise bei Oberflächlichem.
Die Beurteilung von TeilnehmerInnen erfolgt zu einem kleinen Teil über kurze MC Fragen in den Lektionen und vor allem über die wöchentlichen Labs, in denen programmiert wird. Besonders positiv hervor zu heben ist dabei das Design der Labs. Um die verteilte Ausführung zu simulieren, wird eine bereitgestellte virtuelle Maschine, welche die relevanten Programme ausführt, als Worker installiert und als Treiberprogramm laufen die Labs als IPython Notebooks im lokalen Browser. Der bearbeitete Programmcode wird als Python Skript gepeichert und dann auf edX hochgeladen, um den Code durch einen Autograder überprüfen zu lassen. Die Einrichtung des beschriebenen Setups für die Labs und das Durchführen einer Test Benotung ist dann auch die zu erledigende Aufgabe in der ersten Woche.
2. Woche - Getting started
Die zweite Woche startet mit einer eher theoretischen Lektion über die Voraussetzungen für Computersysteme, um mit Big Data umgehen zu können und wie diese in Spark umgesetzt sind. In der vierten Lektion wird dann endlich in die Logik von Spark eingeführt. RDDs, Transformations, Actions, das Daten Caching, Key-Value RDDs und besondere Variable (Broadcast V und Accumulatoren) werden erklärt.
Im Lab für die zweite Woche kann zuerst ein (unbenotetes) Tutorium absolviert werden. In der eigentlichen Aufgabe werden die Anforderungen graduell gesteigert und es muss ein WordCount Skript zum zählen von Wörtern in einem Textdokument (Texte von Shakespear) erstellt werden. Das Lab versucht praxisnah zu sein, was auch überwiegend gelingt. Die große Herausforderung, an geeignete Daten zu kommen, wird nicht umgesetzt, dafür muss der vorhandene Datensatz aber (zumindest rudimentär) bereinigt und effizient weiterverarbeitet werden. Überhaupt wird bislang in diesem MOOC ein Fokus auf die effiziente Verteilung, Analyse und Verarbeitung der Daten gelegt, was sehr zu begrüßen ist. Sind alle Aufgaben gelöst, bekommt man die 15 häufigst verwendeten Wörtern in Shakespear-Texten präsentiert - da stop words vorher nicht entfernt werden mussten, sind es dann auch die üblichen Verdächtigen ;)
...to be continued...
2015/05/24
Storytelling mit Odyssey.js
Mit Odyssey.js wird es einem ziemlich einfach gemacht, interaktive kartenbasierte Stories zu erstellen. Mit ein bisschen Markdown und wenigen Klicks sind schnell ein paar Slides mit Kartenausschnitten zu einer interaktiven Geschichte zusammen zu stellen.
Kartenbasierte Geschichten
Odyssey.js ist ein Open Source Projekt von CartoDB und weist noch einen relativ frühen Entwicklungsstand auf. Einiges funktioniert nicht wie es sollte (z.B. die Leaflet Integration) und die Auswahlmöglichkeiten sind teilweise auch noch bescheiden. Aktuell ist es beispielsweise nur möglich zwischen 3 Basiskarten zu wählen. Die Markdown Umsetzung ist auch noch nicht ganz ausgereift. Für erste Versuche und ein paar visuell ganz ansprechende Stories ist das Tool aber schon zu gebrauchen. Als Resultat kann die erstellte kartenbasierte Story in HTML lokal gespeichert, als iFrame in eine Webpage eingebunden oder als eigenständige Page (gehostet über die Projektseite) verwendet werden.
Das Projekt ist mMn aus zwei Gründen sehr sinnvoll. Einerseits ist es ein weiterer Baustein, um Kartenanwendungen zu demokratisieren. Es ermöglicht einen einfachen Zugang zur Erstellung und Verbreitung eigener webbasierter Karten auch für GIS-Laien. Andererseits ermöglicht das Projekt eben die Zusammenstellung der Karten in Stories, inklusive interaktiver Features für BetrachterInnen. Gerade diese Möglichkeit macht das Tool mMn für die Sozialforschung interessant, um beispielsweise qualitative Ergebnisse in den geografischen Kontext zu setzen und dieses Aggregat als gemeinsame Geschichte zu präsentieren. Ausserdem kann damit RezipientInnen auch ermöglicht werden, mit diesen Ergebnissen zu interagieren, ohne den mühsamen Umweg, die Interaktion selbst entwickeln zu müssen.
Beispielgeschichte
Das Thema dieses Beispiels liegt nicht in der Sozialforschung, sondern in der Werbung. Es soll zeigen, wie mit wenig Aufwand der geografische Kontext eines Produktes mit dessen Entstehungsprozess so verbunden werden kann, dass BetrachterInnen einen näheren Bezug zum Produkt entwickeln. Da in diesem Anwendungsfall die exakte geografische Darstellung nicht von zentraler Bedeutung ist, wurde der Watercolor Style von Stamen Design für die Basiskarten verwendet und die PoI's auch nicht exakt verortet. Der Inhalt ist entsprechend eines schnellen Prototyps natürlich auch nicht ausgereift.
Hier der Link zur Geschichte über den Weg meines Lieblingskaffees.
2015/05/20
Spyre - Framework für Python Datenprojekte
Was dem Python Daten Ökosystem bislang noch fehlt, ist ein Modul um webfähige Datenprodukte, schnell und mit wenig Aufwand, zu erstellen. Adam Hajari hat einen ersten Versuch unternommen, das zu ändern und begann die Entwicklung von Spyre. Um dieses Framework zu testen, habe ich eine kleine Beispielapplikation geschrieben, das im Repo für diesen Blog unter den Python Beispielen zu finden ist.
Ein Spyre Server basiert übrigens auf dem CherryPy Web Framework. Wer daran ein bisschen herum bastelt, kann übrigens auch Spyre Apps auf einen Raspberry Pi 2 zum Laufen bringen (siehe Foto unten). Das halte ich für insofern interessant, da es damit möglich wird, Sensordaten abzugreifen, zu verarbeiten und jetzt eben auch im Internet zu präsentieren mit einer durchgängigen Programmiersprache und auf einem Gerät.
Daten von Strava
Für das Beispiel habe ich ein paar Daten zu meinen sportlichen Aktivitäten in diesem Jahr von Strava herunter geladen. Die Strava API ist zwar nicht gerade ein Highlight in Bezug auf UX beim Datenabgreifen, aber es gibt zumindest ein (selten schlecht dokumentiertes) Python Modul, das die Verbindung managt und somit die Angelegenheit ein bisschen schmerzfreier gestaltet. Das Skript, mit dem ich die Kollektionen mit meinen Radfahr- und Schwimm-Aktivitäten erstellt habe, ist auch im Beispiel Verzeichnis zu finden. Sie enthalten die Art der Aktivität, die Startzeit, Dauer und Distanz.
Spyre Apps
Nach der Installation von Spyre (das Paket heisst dataspyre bei pip) und dem Download des master Repos des Projekts kann gleich mit dem Testen der Beispielanwendungen begonnen werden. Diese sind sehr auf Plots fixiert, es ist z.B. auch möglich Bokeh Plots zu integrieren, aber auch diverse Matplotlib Derivate können gerendert werden. Aber auch das Erzeugen von Tabellen wird durch ein Beispiel abgedeckt. Wirklich sehr nützlich um sich mit dem Modul vertraut zu machen, ist das Tutorial im Spyre Repo, im Form eines Ipython Notebooks. Darin wird anhand der Beispielanwendungen die wichtigsten Input-Elemente (div. Buttons, Slider, Dropdown etc.) und Output-Möglichkeiten (Plot, Tabelle etc.) des Frameworks erklärt.
Von den Beispielen im Spyre Repo habe ich dann auch meine Beispielanwendung abgeleitet (hier ist der Code dazu). Um die Anwendung zu starten genügt es, das Hauptskript mit Python (in einer 2er Version) zu starten und im Browser der Wahl den Port 9097 vom localhost aufzurufen. Wie in dem Foto rechts zu sehen ist, kann dann mit einem Dropdown die Sportart gewählt werden. Der Plot (der Simplizität zuliebe mit Pandas erzeugt) zeigt daraufhin die Tage, an denen die Aktivität statt fand und die Distanz, welche mit dem Rad bzw. im Schwimmbecken zurück gelegt wurde.
 |
| Daten App im Browser |
Von den Beispielen im Spyre Repo habe ich dann auch meine Beispielanwendung abgeleitet (hier ist der Code dazu). Um die Anwendung zu starten genügt es, das Hauptskript mit Python (in einer 2er Version) zu starten und im Browser der Wahl den Port 9097 vom localhost aufzurufen. Wie in dem Foto rechts zu sehen ist, kann dann mit einem Dropdown die Sportart gewählt werden. Der Plot (der Simplizität zuliebe mit Pandas erzeugt) zeigt daraufhin die Tage, an denen die Aktivität statt fand und die Distanz, welche mit dem Rad bzw. im Schwimmbecken zurück gelegt wurde.
Ein Spyre Server basiert übrigens auf dem CherryPy Web Framework. Wer daran ein bisschen herum bastelt, kann übrigens auch Spyre Apps auf einen Raspberry Pi 2 zum Laufen bringen (siehe Foto unten). Das halte ich für insofern interessant, da es damit möglich wird, Sensordaten abzugreifen, zu verarbeiten und jetzt eben auch im Internet zu präsentieren mit einer durchgängigen Programmiersprache und auf einem Gerät.
Zusammenfassung
Mit Spyre ist es möglich, webfähige Datenprodukte durchgehend in Python zu erstellen, ohne auf Übersetzungen in eine andere Sprache (wie zB bei plot.ly) und den damit verbundenen Einschränkungen, angewiesen zu sein. Die Funktionalität und Usability ist aber im Vergleich zum R Ökosystem mit Shiny jedoch sehr bescheiden und benötigt noch jede Menge Entwicklungsarbeit der Community. Es bleibt zu hoffen, dass das Projekt weiter an Bedeutung zunimmt und eventuell auch eine Plattform wie ShinyApps.io, nur für das Python Daten Ökosystem, entstehen lässt. Insbesonders für die adäquate Präsentation von Analyse-Ergebnisse oder Daten-Modellen ist ein Modul wie Spyre bedeutend, um datenwissenschaftliche Prozesse durchgehend in Python zu ermöglichen.
2015/03/24
Geo-App: Schlösser und Burgen in OÖ
Als Beispiel-Projekt habe ich eine Geo-App entwickelt. welche den Standort von Schlösser und Burgen in Oberösterreich visualisiert. Sie dient zur Ergründung solcher Bauwerke in der eigenen Umgebung, kann auch Informationen beim Wandern bereit stellen oder zur Planung von Ausflügen verwendet werden.
Dieser Eintrag wird den Entstehungsprozess thematisieren. Die App selbst ist auf folgender Seite erreichbar:
Dieser Eintrag wird den Entstehungsprozess thematisieren. Die App selbst ist auf folgender Seite erreichbar:
Daten von Wikipedia
 |
| Burg Ruttenstein, Foto © S. Wiesinger, 2014 |
 |
| Schloss Lamberg, Foto CC-BY 4.0 Int. T.Treml, 2015 |
Um Oberösterreich hervor zu heben, habe ich wieder auf einen DORIS Datensatz vom Land OÖ zurück gegriffen. Dieser ist zwar stark generalisiert, was aber im Kontext dieser App ein Vorteil ist, da Speicherplatz und Ladezeiten dadurch vermindert werden. Um Zweiteres zu verbessern wird er vor dem Rendern im Browser auch noch weiter generalisiert.
Die extrahierten Daten wurden dann in QGIS geoprozessiert und in ein Datenmodell transformiert. Dieses wurde mit MongoDB umgesetzt, da dessen Schemalosigkeit die Entwicklung vereinfachte und die damit mögliche Geoindexierung effiziente Abfragen versprach.
 |
| Übersicht Karte |
Flask-App mit Bootstrap Frontend
Das Backend der App basiert auf dem Python Framework Flask und wie erwähnt MongoDB. Die Architektur folgt einem vereinfachten MVC Modell.
Das Frontend wurde auf dem Bootstrap Framework aufgesetzt, vor allem um die App auch responsiv zu gestalten. Das ist besonders für den Anwendungsfall der mobilen Abfrage von Objekten nötig, beispielsweise wenn sich ein/e Benutzer/in beim Wandern oder einem Spaziergang befindet und erfahren möchte, wo sich die nächste Burg oder das nächste Schloss befindet. Grundsätzlich nimmt den größten Teil der Frontpage die ganzseitige Karte mit den visualisierten Objekten ein. Eine Navigationsleiste ermöglicht noch das Aufrufen einer kurzen Anleitung und Informationen über die Daten und der App. Diese Informationen wurden auf eine eigene Seite ausgelagert.
Die Kommunikation zwischen Front- und Backend wurde mit einem Zusammenspiel von Flask mit AJAX und jQuery umgesetzt und könnte bei weitem besser entwickelt sein - bin leider kein Software Ingenieur. In diesem Zusammenhang sei auch erwähnt, dass die App für einen unternehmerischen Einsatz an manchen Stellen noch robuster programmiert werden müsste. Für ein Beispiel, das die Möglichkeiten mit den verwendetetn Daten und Techniken zeigt, sollte dieser Entwicklungsstand aber ausreichen.
Als Basiskarte habe ich mich für das Open Static Map Service von MapQuest entschieden. Der Toner Style von Stamen Design hätte zwar grafik-design-technisch mehr her gegeben, aber die MapQuest Tiles geben durch ihr Farbschema visuell Informationen über die geografische Verortung der Bauwerke intuitiver preis.
Der Standort der Schlösser und Burgen wird durch Marker angezeigt. Ein Piktogramm darauf zeigt an, zu welchem Typ das Objekt gehört. Durch das Auswählen eines Markers mittels Click, öffnet sich ein Pop-Up, das den Namen des Bauwerks und einen Link zu dessen Seite auf Wikipedia enthält, um sich näher über das jeweilge Schloss oder die Burg informieren zu können.
Mit einem Button auf der Karte, ist es möglich, seinen eigenen Standort durch die App anzeigen zu lassen. Dabei wird auf Geoinformation aus dem Browser zurück gegriffen, was erst mit mobilen Geräten wirklich Sinn macht. Dennoch ist die Standortbestimmung damit nicht in allen Gegenden, auch trotz dem Einsatz von GPS, wirklich gut. Über die Einschränkungen ist dieser Artikel recht informativ. Jedenfalls, als Näherungswert, sollte die Bestimmung dennoch ausreichen.
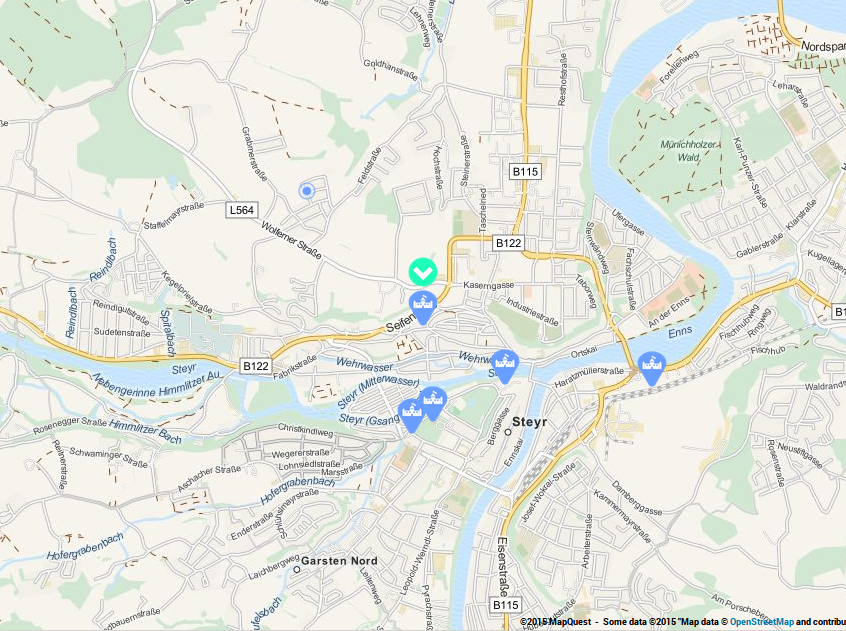
Sobald die App den Standpunkt bestimmt hat, wird aus der Datenbank das geografisch nächste Schloss oder die nächste Burg abgefragt. Die Bestimmung des nächsten Objekts vereinfacht der räumliche Index in MongoDB ungemein und ist mit einer einfachen Anfrage auszuführen. Auf der Karte wird das nächste Bauwerk dann mit einem eigenen Marker hervorgehoben.
 |
| Marker mit Pop-Up |
Die Kommunikation zwischen Front- und Backend wurde mit einem Zusammenspiel von Flask mit AJAX und jQuery umgesetzt und könnte bei weitem besser entwickelt sein - bin leider kein Software Ingenieur. In diesem Zusammenhang sei auch erwähnt, dass die App für einen unternehmerischen Einsatz an manchen Stellen noch robuster programmiert werden müsste. Für ein Beispiel, das die Möglichkeiten mit den verwendetetn Daten und Techniken zeigt, sollte dieser Entwicklungsstand aber ausreichen.
Geo-App mit Leaflet
Die Karte selbst wurde mit Leaflet umgesetzt. Mein Konzept für die Visualisierung konnte damit (und auch Dank der verwendeten Plugins) sehr effizient umgesetzt werden.Als Basiskarte habe ich mich für das Open Static Map Service von MapQuest entschieden. Der Toner Style von Stamen Design hätte zwar grafik-design-technisch mehr her gegeben, aber die MapQuest Tiles geben durch ihr Farbschema visuell Informationen über die geografische Verortung der Bauwerke intuitiver preis.
 |
| Standortbestimmung |
Mit einem Button auf der Karte, ist es möglich, seinen eigenen Standort durch die App anzeigen zu lassen. Dabei wird auf Geoinformation aus dem Browser zurück gegriffen, was erst mit mobilen Geräten wirklich Sinn macht. Dennoch ist die Standortbestimmung damit nicht in allen Gegenden, auch trotz dem Einsatz von GPS, wirklich gut. Über die Einschränkungen ist dieser Artikel recht informativ. Jedenfalls, als Näherungswert, sollte die Bestimmung dennoch ausreichen.
Sobald die App den Standpunkt bestimmt hat, wird aus der Datenbank das geografisch nächste Schloss oder die nächste Burg abgefragt. Die Bestimmung des nächsten Objekts vereinfacht der räumliche Index in MongoDB ungemein und ist mit einer einfachen Anfrage auszuführen. Auf der Karte wird das nächste Bauwerk dann mit einem eigenen Marker hervorgehoben.
Deployment auf OpenShift
Weil die Datenbank wenig umfangreich ist und sich auch der Rechenaufwand zur Darstellung der Page in Grenzen hält, wird die App auf einem einzigen Gear in OpenShift gehostet. Problematisch war hierbei nur die alte Version von MongoDB in der Standard-Cartridge. Da die App mit einer neueren Version der Geoindizes lokal entwickelt wurde, habe ich eine aktuelle Version in OpenShift nachgerüstet - was Dank der MongoDB 2.6 Cartridge von Ionut-Cristian Florescu kein großes Problem war.Zusammenfassung
Mit der Entwicklung dieser Geo-App habe ich versucht zu zeigen, wie es möglich ist mit relativ simplen Mitteln und offenen Daten die Visualisierung von Standorten von mehreren Objekten umzusetzen. Das Thema des Beispielprojekts, Schlösser und Burgen in Oberösterreich, ist touristisch nutzbar. Das beschriebene Vorgehen ist aber auch auf andere statische Objekte wie beispielsweise Geschäftsniederlassungen, Standorte von sportlichen oder kulturellen Einrichtungen etc. anwendbar. Erweiterungsmöglichkeiten sind auch vorhanden, beispielsweise im Rendern von 3D-Modellen der einzelnen Bauwerke an ihren Standorten bei hohen Zoomstufen.Aus Sicht der Sozialforschung ist der Blick auf die Karte auch nicht uninteressant, liefert sie doch eine Darstellung der Verteilung von machtdarstellenden Bauwerken in früheren Zeiten. Dabei ist besonders markant (wenn auch nicht unlogisch), dass sich solche Gebäude in jenen Gebieten konzentrieren, die noch Heute bevölkerungsreich sind, wohin gegen in ländlichen Regionen solche Objekte verstreut in der Landschaft liegen, wobei diese nicht zwangsläufig in Nähe aktueller regionaler Zentren liegen müssen. Hinsichtlich der Sozialforschung ist des weiteren auch bemerkenswert, dass gemeinschaftlich auf Wikipedia erstellte Information, nicht nur umfangreicher, sondern auch gültiger sein kann, als ein von offizieller Stelle publizierter Datensatz.
Die zum Projekt gehörenden Scripte und der Source Code der App sind im Webbeispiele Repository dieses Blogs ersichtlich. Für die Planung von Tageausflüge und -in eingeschränktem Masse- auch mobil für die Orientierung bei einer Wanderung, lässt sich die App auf jedem Fall nutzen. Auch das Ergründen von bislang einem noch unbekannten Bauwerke kann ganz spannend sein.
 |
| Burgruine Ruttenstein, Foto © S. Wiesinger, 2014 |
2014/12/21
Buchrezension: Rewire
In letzter Zeit habe ich das Buch Rewire: Digital Cosmopolitans in the Age of Connection von Ethan Zuckerman gelesen. Als Thema wird darin menschliche Kommunikation und Interaktion im Internetzeitalter besprochen.
Das Buch liest sich sehr soziologisch. Dem Menschen wird darin eine eindeutig höhere Bedeutung zugewiesen als der auch reichlich erwähnten Technik. Mir persönlich war der Inhalt aber zu oberflächlich dargestellt, wem jedoch massenmediale Anekdoten zu Themen mehr interessieren als die theoretische Wissenbasis, ist bei Zuckerman genau richtig. Nichtsdestotrotz finde ich das Buch sehr empfehlenswert, nämlich in Bezug auf der thematischen Aufbereitung durch den Autor und dessen lebendiger Erzählweise.
Ende Versuch: Umstellung auf Kleinschreibung
Wie in diesem Beitrag beschrieben, habe ich die letzen Einträge in Kleinschreibung verfasst. Das Experiment ist meiner Meinung nach nicht aufgegangen und darum stelle ich den Versuch jetzt ein. Hauptausschlagender Grund dafür ist, dass es mir mehr Mühe kostet, einen Text ausschließlich in Kleinschreibung zu verfassen, da ich sonst auch mit Groß- und Kleinschreibung unterscheidenden Systemen arbeite. Insofern kosten mich die Tippfehler durch automatisches Umschalten mehr Zeit als ich durch das Weglassen der Umschaltung gewinne. Dazu finde ich, hat sich das Schriftbild des Blogs nicht verbessert (jedoch auch nicht verschlechtert). Die Lesbarkeit der Beiträge hat aber auch gelitten, einfach aus dem Grund, weil die Unterscheidung zwischen Groß- und Kleinschreibung kulturell so eingebrannt ist. Das könnte sich also durch eine weitere Verbreitung der Kleinschreibung verbessern, aktuell ist es mir jedoch noch zu nachteilig.
2014/10/31
visualisierung mit bokeh: beliebte vornamen in OÖ
erste versuche mit Bokeh
Bokeh ist eine python bibliothek für interaktive visualisierungen und datenplots. entwickelt wird sie von Continuum Analytics, das durch seine python distribution anaconda bekannt ist. die als open-source projekt entwickelte bibliothek erlaubt es, mit python interaktive und webfähige plots zu erzeugen - und das auf simple und schnelle art und weise. genug gründe für mich (als nicht unbedingten fan der matplotlib) einmal erste versuche damit zu starten.
die einbindung der bibliothek ist nicht schwierig zu bewerkstelligen. auch die anwendung zur erzeugung der plots erzeugt keinen syntaktischen overhead, wie der code für die beispielanwendung zeigt (einseh- und downloadbar im visualisierungs-beispiele repo des blogs). die ergebnisse sind für den geringen aufwand visuell ansprechend und auch nützlich für die kommunikation von informationen aus den plots. bei meinen versuchen haben sich jedoch zwei problemfelder gezeigt, die dem noch jungen entwicklungsstands des projekts geschuldet sind. erstens ist die dokumentation noch sehr ausbaufähig. damit bleibt nichts anderes übrig, als bei der verwendung öfters mal im sourcecode der bibliothek nachzusehen. dieser ist zwar gut kommentiert und hilft, die korrekte anwendung von diversen methoden zu finden, kann aber eine gute dokumentation für das schnelle nachschlagen nicht ersetzen. als zweiten problembereich kamen mir dokumentierte parameter unter, die in folge jedoch nicht genutzt werden. dies ist besonders ärgerlich, wenn man die plots individuell verändern möchte. jedoch gehe ich davon aus, dass diese beiden problemgruppen in weiteren entwicklungsstadien behoben werden.
als beispielanwendung habe ich mich auf eine simple visualisierung mittels einer heatmap festgelegt. da bokeh auch eine eigene methode und ein beispiel in der gallery bereit stellt. als zusätzliches ziel setzte ich mir die einbindung eines bokeh-plots in eine statische webseite.
als beispielanwendung habe ich mich auf eine simple visualisierung mittels einer heatmap festgelegt. da bokeh auch eine eigene methode und ein beispiel in der gallery bereit stellt. als zusätzliches ziel setzte ich mir die einbindung eines bokeh-plots in eine statische webseite.
thema: beliebte vornamen
als datenquelle für dieses projekt hat sich der vornamen datensatz des landes oö (über daten.gv.at) angeboten. dieser enthält die 60 beliebtesten vornamen je geschlecht für die letzten 10 jahre. daraus wurden die 25 beliebtesten (nach summe der werte über die gesamtjahre) bestimmt und deren werte dann in einem pandas data frame in eine entsprechende form gebracht, um als input für die CategoricalHeatMap methode von Bokeh zu dienen. im endeffekt stellte sich heraus, dass die größte herausforderung des projekts -wie so oft bei datenanalysen und- visualisierungen- darin bestand, die daten in die gewünschte form zu bringen. die erstellung der eigentlichen plots mittels bokeh ging dann recht zügig.
sobald die visualisierungen erstellt waren, wurden die plots in ein bootstrap template importiert. das vorgehen (im web-beispiele repo des blogs dokumentiert), hätte ich zwar eleganter gestalten können, für eine schnelle präsentationsmöglichkeit ist die einbindung des html-outputs von bokeh aber geeignet. eine bedeutende verbesserung wäre natürlich eine interaktive einbindung, was auch eine effektive verwendung in dynamischen seiten erlauben würde. dies scheint mit bokeh auch möglich zu sein - aber auch hier fehlt noch eine bessere dokumentation. für den anspruch, ein einfaches beispiel zu gestalten, hat mir aber die einbindung des kompletten outputs gereicht. die ergebnisse über die 25 beliebtesten vornamen für männliche und weibliche neugeborene kann somit unter folgendem link betrachtet werden:
zusammenfassung
einbindung und verwendung der python visualisierung-bibliothek Bokeh sind einfach. das potential des projekts ist gross, aktuell gibt es jedoch noch einige mängel, va bezüglich der dokumentation.
und zum ergebnis des beispiels: Lukas bzw. Anna sind die beliebtesten vornamen für neugeborene in den letzten 10 jahren in oberösterreich. die plots zeigen darüber hinaus, dass es besonders bei weiblichen neugeborenen eine konzentration von besonders häufig verwendeten vornamen gibt. ein trend zu mehr individualität bei der benennung von neugeborenen ist zumindest mit diesen vorliegenden daten für die letzten 10 jahre nicht erkennbar.
und zum ergebnis des beispiels: Lukas bzw. Anna sind die beliebtesten vornamen für neugeborene in den letzten 10 jahren in oberösterreich. die plots zeigen darüber hinaus, dass es besonders bei weiblichen neugeborenen eine konzentration von besonders häufig verwendeten vornamen gibt. ein trend zu mehr individualität bei der benennung von neugeborenen ist zumindest mit diesen vorliegenden daten für die letzten 10 jahre nicht erkennbar.
2014/09/22
geokodierungsskript für MapQuest API
da es zwar aktuelle einige bibliotheken für python 2.x gibt, welche geokodierung mit Hilfe der MapQuest Open Geocoding API zur verfügung stellen, aber keine kompatible version für python 3.x, habe ich ein kleines Skript dafür geschrieben und auf GitHub gestellt. voraussetzung zur verwendung ist ein authorisierungs schlüssel, der auf der entwicklerseite von MapQuest erzeugt werden kann.
das skript kann in ein projekt kopiert werden, das koordinaten für bestimmte orte benötigt. der aufruf der funktion geocodeMQ mit dem parameter der jeweiligen ortsabfrage, stellt dann genau diese bereit, in dem es auf die Open Geocoding API von Mapquest zugreift. diese daten basieren auf OpenStreetMaps-daten und stehen unter der ODbL. es werden die koordinaten des besten treffers als koordinatentupel (breite, länge) zurück gegeben und können zur weiteren prozessierung verwendet werden.
2014/08/22
reporting mit flask
um die möglichkeiten von flask zum erstellen eines reports zu testen, habe ich ein einfaches beispiel über wohnbautätigkeiten zusammen gestellt. zum ausprobieren der anwendung steht der code im python repo von diesem blog unter FlaskReporting zur verfügung.
 |
| home screen |
thema: wohnbautätigkeit in österreich
da es in dem beispiel eigentlich um die anwendung gehen sollte, habe ich datenzusammenstellung, -analyse und -visualisierung simpel gehalten. die daten stammen von statistik austria [ironiemodus an] DEM ansprechpartnerfür historische daten von österreich [ironiemodus aus] und bestehen aus 2 datensätze über die anzahl von fertiggestellten gebäuden mit wohnungen pro jahr. der insgesamte zeitraum der beobachtung ist somit zwischen 1970 und 2002. die datenwerte sind auch relativ unspektakulär mit nur einem ausreisser (in 1980), der eventuell mit mehr historischem wissen erklärbar wäre oder auch nur ein aggregation fehler ist.
für den report habe ich die daten dann so aufbereitet, dass eine zusammenfassende statistik der anzahl der gebäuden und ein einfaches diagramm über die selbe variable zu sehen ist. dazu noch ein bisschen erklärender text und fertig ist die simplifizierte version eines datenanalyse reports.
flask
mit ein wenig kenntnissen in python und einigen tutorials war es überaus einfach, mit geringem aufwand, eine einfache reporting app zu entwickeln. der code der anwendung ist mehr oder weniger selbsterklärend. grundsätzlich gibt es ein main script mit dem code für flask und ein analyse script, das die datenanalyse und -visualisierung (überwiegend mit hilfe von pandas und der matplotlib) zur verfügung stellt. als layout wurde die basis version von bootstrap verwendet, das über eine erweiterung auch flott in flask integriert werden konnte. dadurch genügten ein paar zeilen code in den html templates, um so einen simplen report zusammen zu stellen.
 |
| report |
zusammenfassung
flask ist mmn überaus geeignet, einfache reports oder andere datenprodukte ins web zu bringen. die verwendung des frameworks zeigt sich recht einfach, setzt jedoch etwas an wissen über html und css voraus.
2014/08/20
versuch: umstellung auf kleinschreibung
ab sofort starte ich den versuch, meine einträge in kleinschreibung zu verfassen. auf die idee brachte mich das lesen vom das vegan magazin (obwohl selbst nicht veganer) und die erinnerung an ein mal gelesenes buch eines italienischen autors, der sich ebenfalls der kleinschrift bediente. getestet soll werden, ob mir das konsequente klein-schreiben tatsächlich leichter fällt, wie sich die entscheidung auf das gesamte schriftbild des blogs auswirkt und ob die lesbarkeit der beiträge dadurch beeinträchtigt wird. persönliche erfahrungen oder meinungen dazu bitte über kontaktformular auf der seite.
2014/07/27
Migrationsbilanz als ShinyApp
Für das Kurs-Projekt vom MOOC Developing Data Products habe ich eine simple Visualisierungs App entwickelt. Sie bereitet Migrationsdaten aus dem Zeitraum 2002 - 2012 der Bezirke von Oberösterreich in Form einer Choroplethenkarte auf und zeigt die Werte auch in Tabellenform.
Link zu shinyMig OÖ
ShinyApps.io
Umgesetzt wurde das Projekt zu Versuchszwecken in R auf der ShinyApps.io Plattform von RStudio. Das Deployment hierbei zeigte sich mehr als simpel. Sofern die Anwendung auf der eigenen Workstation einwandfrei läuft, kann es mit einem einfachen deployApp() Befehl auf die Plattform geladen werden. Die Kunst ist lediglich, die Anwendung am eigenen Rechner fehlerfrei zum Laufen zu bringen, da die debugging Möglichkeiten mit shiny leider noch sehr begrenzt sind.
Umsetzung in R
Bei der Entwicklung der App zeigte sich wieder eindeutig, dass R nur ein suboptimales Werkzeug zur Kartenerstellung ist. Mit ggplot2 ist zwar einiges möglich, der Aufwand dafür steht jedoch mMn nicht in Relation zu den mässigen Ergebnissen im Vergleich zu echter GIS-Software. Bei der Aufbereitung der Rohdaten (übrigen von data.gv.at) und der tabellarischen Darstellung in der App, konnte hingegen R natürlich seine Stärken ausspielen. Als größtes Hindernis bei der Entwicklung stellte sich die Kategorisierung der Migrationsbilanzen heraus, wobei ich mich nach etlichen Versuchen in automatischer- und einiger in manueller-Klassifizierung für einen semi-automatischen Weg entschieden habe, wobei positive und negative Salden getrennt und von diesen beiden Kategorien dann der jeweilige Median als weitere Schwelle eingeführt wurde. Damit blieb die visuelle Vergleichbarkeit der Karten noch einigermassen erhalten, bei Beibehaltung des Akzents auf die Trennung von positiven und negativen Werten. Für detaillierte Vergleiche sind ja noch die jeweiligen Schwellen in der Legende verzeichnet bzw. auch die Daten in der Tabelle ersichtlich.
Beispielcode
Der Beispielcode steht im R-Repo dieses Blogs zum download bereit.
2014/07/23
Buchrezension: Lifelogging von Stefan Selke
In den letzten Wochen habe ich das Buch "Lifelogging: Wie die digitale Selbstvermessung unsere Gesellschaft verändert" von Stefan Selke gelesen. Als regelmässiger Leser seines Blogs Stabile Seitenlage und da mir seine Posts im SozBlog sehr zugesagt haben, ging ich mit großen Erwartungen in die Auseinandersetzung mit dem Thema Lifelogging.
Licht und Schatten
Der Schreibstil des Autors sagt mir immer wieder zu. Er vermag nämlich komplexe gesellschaftlich Zusammenhänge, so zu präsentieren, dass sie einfach zu verstehen sind, aber dennoch keine bedeutenden Aspekte verloren gehen. Auch finde ich sehr gelungen, dass positive wie auch negative Entwicklungen und mögliche Auswirkungen des Lifeloggings angesprochen werden. Positive sind zwar eindeutig unterrepräsentiert, aber werden zumindest erwähnt, was im Vergleich zur Mainstream Medienlandschaft schonmal einem Quantensprung gleich kommt.
Vor allem das Ende des Buches kam mir dann doch etwas zu langatmig vor. Das letzte Kapitel, ein Ausblick auf die Zukunft (was mMn in der Soziologie allzu oft fehlt) mal ausgenommen, waren mir Aneinanderreihungen von dystopischen Beschreibungen über mögliche negative Auswirkungen des Lifeloggings auf Dauer einfach zu viel. Auch die Glorifizierung sozialer und psychologischer Mechanismen im Gegensatz zu technischen Regulationssystemen kann ich zwar als Soziologe nachvollziehen, ist jedoch mMn eine antiquierte Haltung, sowohl im Bezug auf Erstere, wie auf Letztere. Eine trennschärfere Auseinandersetzung über Datenanwendungen und Lifelogging-Techniken hätte ich mir überdies gewünscht.
Vor allem das Ende des Buches kam mir dann doch etwas zu langatmig vor. Das letzte Kapitel, ein Ausblick auf die Zukunft (was mMn in der Soziologie allzu oft fehlt) mal ausgenommen, waren mir Aneinanderreihungen von dystopischen Beschreibungen über mögliche negative Auswirkungen des Lifeloggings auf Dauer einfach zu viel. Auch die Glorifizierung sozialer und psychologischer Mechanismen im Gegensatz zu technischen Regulationssystemen kann ich zwar als Soziologe nachvollziehen, ist jedoch mMn eine antiquierte Haltung, sowohl im Bezug auf Erstere, wie auf Letztere. Eine trennschärfere Auseinandersetzung über Datenanwendungen und Lifelogging-Techniken hätte ich mir überdies gewünscht.
Fazit
Grundsätzlich halte ich das Buch "Lifelogging" aktuell als sehr notwendig. Es bringt etwas Licht in die Grauzone der datenbasierten Technikanwendungen und deren manifesten, aber auch unintentionierten, Auswirkungen auf die Gegenwartsgesellschaften. Ich halte das Werk auch dazu fähig, eine Debatte über den Umgang mit Daten auf gesamtgesellschaftlicher Ebene anzustossen. Ob diese dann auch objektiv geführt werden kann, wage ich zu bezweifeln. Auch gerade weil ich den Grundtenor des Buch als zu sehr auf negative Auswirkungen von datenbasierten Technologien ausgerichtet empfinde.
Umgekehrt als die Ausrichtung auf ein Zielpublikum eigentlich zu erwarten wäre, würde ich das Buch sehr für den stereotypischen Techie empfehlen um dessen Horizont zu erweitern, als Technologie-interessierte Sozialforscher oder einer kritischen Öffentlichkeit, welche eventuell durch die Lektüre in ihrer Datenparanoia bestärkt werden könnten.
Umgekehrt als die Ausrichtung auf ein Zielpublikum eigentlich zu erwarten wäre, würde ich das Buch sehr für den stereotypischen Techie empfehlen um dessen Horizont zu erweitern, als Technologie-interessierte Sozialforscher oder einer kritischen Öffentlichkeit, welche eventuell durch die Lektüre in ihrer Datenparanoia bestärkt werden könnten.
2014/07/10
Twitter: @datadonk23
Nachdem ich jetzt doch mal einen Twitter-Account angelegt habe (für ein Assignment im Rahmen eines MOOC - mehr dazu bald), gibt es jetzt auch Neuigkeiten von mir über Daten, Sozialforschung und alles was mir sonst noch unter kommt auf: @datadonk23
2014/07/06
Visualisierung von Wahlergebnissen mit Qt
Um die Möglichkeiten für die Entwicklung von Android Apps mit Qt zu testen, habe ich eine simple Anwendung zur Visualisierung von Wahlerbnissen erstellt. Das Projekt kann vom Visualisierungs-Beispiele Repositorium herunter geladen und auf Desktop oder neueren Android Versionen getestet werden.
 |
| Screenshot - Wahlergebnisse App |
Wahlergbnisse der EU-Wahl 2014 in Steyr
Da die Daten der letzten politischen Wahl in meiner Heimatstadt einfach zugänglich waren, habe ich diese als Datenbasis verwendet. Diese lagen schon aufbereitet durch die Abteilung für Wahlen der Kommunalverwaltungsbehörde vor und wurden lediglich in XML umgewandelt, um sie durch ein XMLListModel-Objekt in die Anwendung eingebinden zu können.
Tabellenansicht
Auf Basis eines Grid-Layouts wurde dann eine Tabelle mit den Ergebnissen erstellt. Diese ist flickable, mit einer Wischgeste kann also zu den Ergebnissen der Parteien der hinteren Listenplätze gescrollt werden. Auf mehr Interaktion wurde zu Gunsten der Simplizität verzichtet. Uninspirierter Weise wurden die Farben aus dem Standard-Farbschema von Android zur farblichen Gestaltung verwendet.
Fazit
Die Entwicklung einer Android App, die auch auf Desktops lauffähig ist, mit Qt war Dank der umfangreichen Dokumentation des Projekts einfach. Die Integration von tabellarischen Daten und Wiederverwendung in selber Form ist ebenso unkompliziert umzusetzen, wie ein grid-basiertes Layout zur Aufbereitung. Der erstellte Prototyp der App läuft auf Desktop- und neueren Android-Geräten und ist grundsätzlich mit weiteren Features erweiterbar. So wäre eine Navigation zu den einzelnen Stadtteilergebnissen ohne größere Mühen umsetzbar. Eine Darstellung in Diagrammform wäre ebenso denkbar wie sinnvoll, nur etwas umständlicher umzusetzen, da das Datenvisualisierungsmodul von Qt nicht in der OpenSource Version enthalten ist.
2014/05/22
Buchbesprechung: Neo4j 2.0 - Eine Graphdatenbank für alle
Das Buch "Neo4j 2.0 - Eine Graphdatenbank für alle " von Michael Hunger führt in die Benutzung von Neo4j ein. Graphendatenbanken sind besonders bei sozialen Fragestellungen ein geeignetes Instrument, Daten zu prozessieren. Des weiteren gibt es aber eine Vielzahl von anderen Anwendungsfälle dieser relativ neuen Technologie, die auch in dem Buch kurz vorgestellt werden. Dabei liegt der Fokus eher auf Anwendungen im Business Bereich.
Kurz und prägnant
Wie schon der Hinweis "schnell + kompakt" auf der Umschlagseite und das Format (16 * 10 cm) erkennen lässt, ist das Ziel des Buches, einen kurzen und prägnanten Einstieg in die Verwendung der Graphendatenbank, und dessen Standard-Abfragesprache Cypher, bereit zu stellen. Meiner Meinung nach, kann es als durchaus gelungen bezeichnet werden, wie der Autor Michael Hunger es meistert, Einführung, Benutzung, Anwendungsmöglichkeiten und sogar spezielle Problemstellungen auf so wenig Textraum unterzubringen. Der Schreibstil ist dementsprechend auch schnörkellos und gut verständlich. Natürlich wird hier viel auf Codebeispiele gesetzt, die meist auch für sich allein stehend gut nachvollziehbar sind. Durch die Vielzahl an Verbindungsmöglichkeiten mit Neo4j, werden für die hauptsächlichen eingesetzten Kommunikationswege (Datenbankabfragen, API´s, Treiber) jeweils Beispiele geliefert. Diese sind leider sehr auf Java ausgerichtet, was nicht verwundert, da Neo4j ja auch in der Sprache entwickelt wurde. Dennoch werden auch Anbindungen mit anderen Programmiersprachen zumindest erwähnt und auf vertiefende Informationsmöglichkeiten verwiesen.
Die Welt der Graphendatenbanken
Kurz dargestellt, bestehen Graphendatenmodelle aus Knoten und Verbindungen. Aus der Geoinformatik sind solche Konzepte vor allem von Routenberechnungen bekannt. In den letzten Jahren entwickeln sich Graphendatenbanken im Zuge der Verbreitung von NoSQL immer mehr zu funktionalen Lösungen, um komplexe Zusammenhänge zu modellieren. Einerseits ist dafür die Notwendigkeit gegeben, da in einer stark vernetzten Welt, auch modellhafte Abbilder der Struktur von Verbindungen entsprechen sollte, andererseits sind besonders soziale Netzwerke im Web und andere webbasierten Dienste günstige Lieferanten von Datenstrukturen, die sich intuitiv als Netzwerk abbilden lassen - Stichwort Big Data.
Für sozialwissenschaftliche Analysen, aber auch für jeglich Anwendungen, welche soziale Zusammenhänge darstellen (vom Marketing, über Einkauf und Verkauf, bis hin zur Kundendatenbank), sind Lösungen mit Graphendatenbanken überaus geeignet. Die dafür erstellten Modelle sind skalierbar und performant. Der bedeutendste Vorteil liegt meiner Meinung nach aber in der intuitiven Abbildung der sozialen Realitäten. Momentan arbeite ich an einem Beispiel, welches die Möglichkeiten zur Analyse von sozialen Daten demonstrieren soll. Es wird auf diesem Blog dann vorgestellt werden, natürlich inklusive eines Beispielcodes (Anbindung an Neo4j mit Python).
Abonnieren
Posts (Atom)