Posts mit dem Label App werden angezeigt. Alle Posts anzeigen

2015/05/20

Spyre - Framework für Python Datenprojekte

Was dem Python Daten Ökosystem bislang noch fehlt, ist ein Modul um webfähige Datenprodukte, schnell und mit wenig Aufwand, zu erstellen. Adam Hajari hat einen ersten Versuch unternommen, das zu ändern und begann die Entwicklung von Spyre. Um dieses Framework zu testen, habe ich eine kleine Beispielapplikation geschrieben, das im Repo für diesen Blog unter den Python Beispielen zu finden ist.

Daten von Strava

Für das Beispiel habe ich ein paar Daten zu meinen sportlichen Aktivitäten in diesem Jahr von Strava herunter geladen. Die Strava API ist zwar nicht gerade ein Highlight in Bezug auf UX beim Datenabgreifen, aber es gibt zumindest ein (selten schlecht dokumentiertes) Python Modul, das die Verbindung managt und somit die Angelegenheit ein bisschen schmerzfreier gestaltet. Das Skript, mit dem ich die Kollektionen mit meinen Radfahr- und Schwimm-Aktivitäten erstellt habe, ist auch im Beispiel Verzeichnis zu finden. Sie enthalten die Art der Aktivität, die Startzeit, Dauer und Distanz.

Spyre Apps

Nach der Installation von Spyre (das Paket heisst dataspyre bei pip) und dem Download des master Repos des Projekts kann gleich mit dem Testen der Beispielanwendungen begonnen werden. Diese sind sehr auf Plots fixiert, es ist z.B. auch möglich Bokeh Plots zu integrieren, aber auch diverse Matplotlib Derivate können gerendert werden. Aber auch das Erzeugen von Tabellen wird durch ein Beispiel abgedeckt. Wirklich sehr nützlich um sich mit dem Modul vertraut zu machen, ist das Tutorial im Spyre Repo, im Form eines Ipython Notebooks. Darin wird anhand der Beispielanwendungen die wichtigsten Input-Elemente (div. Buttons, Slider, Dropdown etc.) und Output-Möglichkeiten (Plot, Tabelle etc.) des Frameworks erklärt.
Radfahr Daten in Browser App
Daten App im Browser

Von den Beispielen im Spyre Repo habe ich dann auch meine Beispielanwendung abgeleitet (hier ist der Code dazu). Um die Anwendung zu starten genügt es, das Hauptskript mit Python (in einer 2er Version) zu starten und im Browser der Wahl den Port 9097 vom localhost aufzurufen. Wie in dem Foto rechts zu sehen ist, kann dann mit einem Dropdown die Sportart gewählt werden. Der Plot (der Simplizität zuliebe mit Pandas erzeugt) zeigt daraufhin die Tage, an denen die Aktivität statt fand und die Distanz, welche mit dem Rad bzw. im Schwimmbecken zurück gelegt wurde.

Ein Spyre Server basiert übrigens auf dem CherryPy Web Framework. Wer daran ein bisschen herum bastelt, kann übrigens auch Spyre Apps auf einen Raspberry Pi 2 zum Laufen bringen (siehe Foto unten). Das halte ich für insofern interessant, da es damit möglich wird, Sensordaten abzugreifen, zu verarbeiten und jetzt eben auch im Internet zu präsentieren mit einer durchgängigen Programmiersprache und auf einem Gerät.
Ein von @datadonk23 gepostetes Foto am


Zusammenfassung

Mit Spyre ist es möglich, webfähige Datenprodukte durchgehend in Python zu erstellen, ohne auf Übersetzungen in eine andere Sprache (wie zB bei plot.ly) und den damit verbundenen Einschränkungen, angewiesen zu sein. Die Funktionalität und Usability ist aber im Vergleich zum R Ökosystem mit Shiny jedoch sehr bescheiden und benötigt noch jede Menge Entwicklungsarbeit der Community. Es bleibt zu hoffen, dass das Projekt weiter an Bedeutung zunimmt und eventuell auch eine Plattform wie ShinyApps.io, nur für das Python Daten Ökosystem, entstehen lässt. Insbesonders für die adäquate Präsentation von Analyse-Ergebnisse oder Daten-Modellen ist ein Modul wie Spyre bedeutend, um datenwissenschaftliche Prozesse durchgehend in Python zu ermöglichen.

2015/03/24

Geo-App: Schlösser und Burgen in OÖ

Als Beispiel-Projekt habe ich eine Geo-App entwickelt. welche den Standort von Schlösser und Burgen in Oberösterreich visualisiert. Sie dient zur Ergründung solcher Bauwerke in der eigenen Umgebung, kann auch Informationen beim Wandern bereit stellen oder zur Planung von Ausflügen verwendet werden.
Dieser Eintrag wird den Entstehungsprozess thematisieren. Die App selbst ist auf folgender Seite erreichbar:


Daten von Wikipedia

Burg Ruttenstein, Foto © S. Wiesinger, 2014
Auf das touristisch verwertbare Thema, Schlösser und Burgen, bin ich durch einen offenen Datensatz des Landes OÖ gekommen. Wie sich jedoch erst heraus stellte, fehlten in diesem Datensatz eine größere Anzahl an Objekten, insbesonders (aber nicht nur) die touristisch interessanten Burgruinen. Aus den Metadaten war das so leider auch nicht ersichtlich. Genau so unzuverlässig und halbherzig dokumentiert sollten Open Data eigentlich nicht sein.
Schloss Lamberg, Foto CC-BY 4.0 Int. T.Treml, 2015
Als Alternative habe ich mich für die Verwendung von Daten von Wikipedia entschieden. Dazu habe ich ein kleines Script geschrieben, das die jeweilgen Namen der Bauwerke, einen Link zur jeweiligen Wikipedia Seite (als Information für die Pop-Ups in der App) und die Geokoordinaten extrahiert. Die Verortung ist zwar weniger genau, als jene im Datensatz des Landes, jedoch ist die Anzahl der Objekte umfassender, insbesonders die erwähnten Ruinen kommen hierbei auch vor. Darüber hinaus klassifiziert das Script die Bauwerke noch, um eine Unterscheidung zwischen Burgen und Schlösser bei der Visualisierung zu ermöglichen. Bei den von den 324 aufgelisteten Objekten, konnten nur 5 wegen mangelnder Geoverortung oder nicht Verfolgbarkeit der Links nicht verwendet werden. Im Vergleich dazu umfasst der Datensatz des Landes nur 240 Objekte.
Um Oberösterreich hervor zu heben, habe ich wieder auf einen DORIS Datensatz vom Land OÖ zurück gegriffen. Dieser ist zwar stark generalisiert, was aber im Kontext dieser App ein Vorteil ist, da Speicherplatz und Ladezeiten dadurch vermindert werden. Um Zweiteres zu verbessern wird er vor dem Rendern im Browser auch noch weiter generalisiert.

Die extrahierten Daten wurden dann in QGIS geoprozessiert und in ein Datenmodell transformiert. Dieses wurde mit MongoDB umgesetzt, da dessen Schemalosigkeit die Entwicklung vereinfachte und die damit mögliche Geoindexierung effiziente Abfragen versprach.

Übersicht Karte

Flask-App mit Bootstrap Frontend

Das Backend der App basiert auf dem Python Framework Flask und wie erwähnt MongoDB. Die Architektur folgt einem vereinfachten MVC Modell.
Marker mit Pop-Up
Das Frontend wurde auf dem Bootstrap Framework aufgesetzt, vor allem um die App auch responsiv zu gestalten. Das ist besonders für den Anwendungsfall der mobilen Abfrage von Objekten nötig, beispielsweise wenn sich ein/e Benutzer/in beim Wandern oder einem Spaziergang befindet und erfahren möchte, wo sich die nächste Burg oder das nächste Schloss befindet. Grundsätzlich nimmt den größten Teil der Frontpage die ganzseitige Karte mit den visualisierten Objekten ein. Eine Navigationsleiste ermöglicht noch das Aufrufen einer kurzen Anleitung und Informationen über die Daten und der App. Diese Informationen wurden auf eine eigene Seite ausgelagert.

Die Kommunikation zwischen Front-  und Backend wurde mit einem Zusammenspiel von Flask mit AJAX und jQuery umgesetzt und könnte bei weitem besser entwickelt sein - bin leider kein Software Ingenieur. In diesem Zusammenhang sei auch erwähnt, dass die App für einen unternehmerischen Einsatz an manchen Stellen noch robuster programmiert werden müsste. Für ein Beispiel, das die Möglichkeiten mit den verwendetetn Daten und Techniken zeigt, sollte dieser Entwicklungsstand aber ausreichen.

Geo-App mit Leaflet

Die Karte selbst wurde mit Leaflet umgesetzt. Mein Konzept für die Visualisierung konnte damit (und auch Dank der verwendeten Plugins) sehr effizient umgesetzt werden.
Als Basiskarte habe ich mich für das Open Static Map Service von MapQuest entschieden. Der Toner Style von Stamen Design hätte zwar grafik-design-technisch mehr her gegeben, aber die MapQuest Tiles geben durch ihr Farbschema visuell Informationen über die geografische Verortung der Bauwerke intuitiver preis.
Standortbestimmung
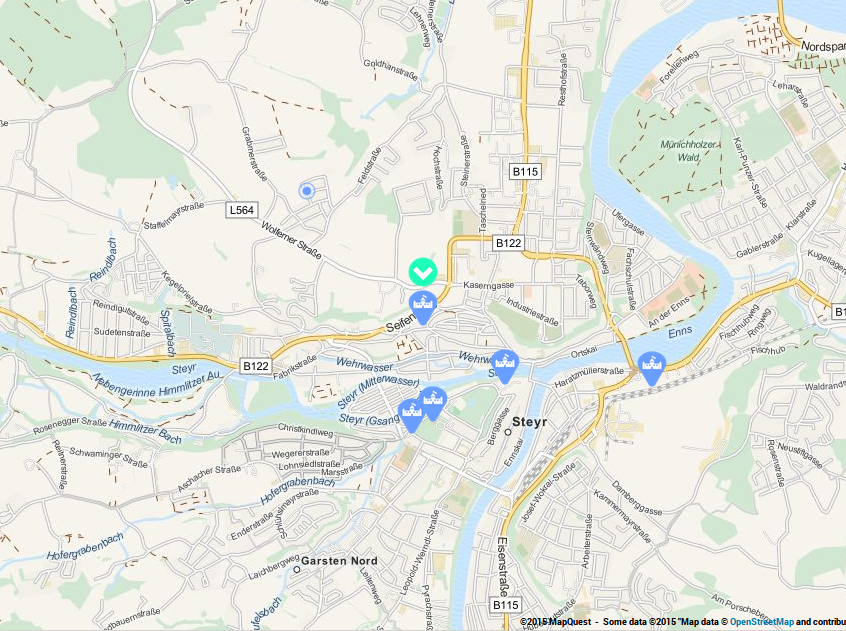
Der Standort der Schlösser und Burgen wird durch Marker angezeigt. Ein Piktogramm darauf zeigt an, zu welchem Typ das Objekt gehört. Durch das Auswählen eines Markers mittels Click, öffnet sich ein Pop-Up, das den Namen des Bauwerks und einen Link zu dessen Seite auf Wikipedia enthält, um sich näher über das jeweilge Schloss oder die Burg informieren zu können.
Mit einem Button auf der Karte, ist es möglich, seinen eigenen Standort durch die App anzeigen zu lassen. Dabei wird auf Geoinformation aus dem Browser zurück gegriffen, was erst mit mobilen Geräten wirklich Sinn macht. Dennoch ist die Standortbestimmung damit nicht in allen Gegenden, auch trotz dem Einsatz von GPS, wirklich gut. Über die Einschränkungen ist dieser Artikel recht informativ. Jedenfalls, als Näherungswert, sollte die Bestimmung dennoch ausreichen.
Sobald die App den Standpunkt bestimmt hat, wird aus der Datenbank das geografisch nächste Schloss oder die nächste Burg abgefragt. Die Bestimmung des nächsten Objekts vereinfacht der räumliche Index in MongoDB ungemein und ist mit einer einfachen Anfrage auszuführen. Auf der Karte wird das nächste Bauwerk dann mit einem eigenen Marker hervorgehoben.

Deployment auf OpenShift

Weil die Datenbank wenig umfangreich ist und sich auch der Rechenaufwand zur Darstellung der Page in Grenzen hält, wird die App auf einem einzigen Gear in OpenShift gehostet. Problematisch war hierbei nur die alte Version von MongoDB in der Standard-Cartridge. Da die App mit einer neueren Version der Geoindizes lokal entwickelt wurde, habe ich eine aktuelle Version in OpenShift nachgerüstet - was Dank der MongoDB 2.6 Cartridge von Ionut-Cristian Florescu kein großes Problem war.

Zusammenfassung

Mit der Entwicklung dieser Geo-App habe ich versucht zu zeigen, wie es möglich ist mit relativ simplen Mitteln und offenen Daten die Visualisierung von Standorten von mehreren Objekten umzusetzen. Das Thema des Beispielprojekts, Schlösser und Burgen in Oberösterreich, ist touristisch nutzbar. Das beschriebene Vorgehen ist aber auch auf andere statische Objekte wie beispielsweise Geschäftsniederlassungen, Standorte von sportlichen oder kulturellen Einrichtungen etc. anwendbar. Erweiterungsmöglichkeiten sind auch vorhanden, beispielsweise im Rendern von 3D-Modellen der einzelnen Bauwerke an ihren Standorten bei hohen Zoomstufen.
Aus Sicht der Sozialforschung ist der Blick auf die Karte auch nicht uninteressant, liefert sie doch eine Darstellung der Verteilung von machtdarstellenden Bauwerken in früheren Zeiten. Dabei ist besonders markant (wenn auch nicht unlogisch), dass sich solche Gebäude in jenen Gebieten konzentrieren, die noch Heute bevölkerungsreich sind, wohin gegen in ländlichen Regionen solche Objekte verstreut in der Landschaft liegen, wobei diese nicht zwangsläufig in Nähe aktueller regionaler Zentren liegen müssen. Hinsichtlich der Sozialforschung ist des weiteren auch bemerkenswert, dass gemeinschaftlich auf Wikipedia erstellte Information, nicht nur umfangreicher, sondern auch gültiger sein kann, als ein von offizieller Stelle publizierter Datensatz.
Die zum Projekt gehörenden Scripte und der Source Code der App sind im Webbeispiele Repository dieses Blogs ersichtlich. Für die Planung von Tageausflüge und -in eingeschränktem Masse- auch mobil für die Orientierung bei einer Wanderung, lässt sich die App auf jedem Fall nutzen. Auch das Ergründen von bislang einem noch unbekannten Bauwerke kann ganz spannend sein.

Burgruine Ruttenstein, Foto © S. Wiesinger, 2014

2014/07/27

Migrationsbilanz als ShinyApp

Für das Kurs-Projekt vom MOOC Developing Data Products habe ich eine simple Visualisierungs App entwickelt. Sie bereitet Migrationsdaten aus dem Zeitraum 2002 - 2012 der Bezirke von Oberösterreich in Form einer Choroplethenkarte auf und zeigt die Werte auch in Tabellenform.

Link zu shinyMig OÖ

ShinyApps.io

Umgesetzt wurde das Projekt zu Versuchszwecken in R auf der ShinyApps.io Plattform von RStudio. Das Deployment hierbei zeigte sich mehr als simpel. Sofern die Anwendung auf der eigenen Workstation einwandfrei läuft, kann es mit einem einfachen deployApp() Befehl auf die Plattform geladen werden. Die Kunst ist lediglich, die Anwendung am eigenen Rechner fehlerfrei zum Laufen zu bringen, da die debugging Möglichkeiten mit shiny leider noch sehr begrenzt sind.

Umsetzung in R

Bei der Entwicklung der App zeigte sich wieder eindeutig, dass R nur ein suboptimales Werkzeug zur Kartenerstellung ist. Mit ggplot2 ist zwar einiges möglich, der Aufwand dafür steht jedoch mMn nicht in Relation zu den mässigen Ergebnissen im Vergleich zu echter GIS-Software. Bei der Aufbereitung der Rohdaten (übrigen von data.gv.at) und der tabellarischen Darstellung in der App, konnte hingegen R natürlich seine Stärken ausspielen. Als größtes Hindernis bei der Entwicklung stellte sich die Kategorisierung der Migrationsbilanzen heraus, wobei ich mich nach etlichen Versuchen in automatischer- und einiger in manueller-Klassifizierung für einen semi-automatischen Weg entschieden habe, wobei positive und negative Salden getrennt und von diesen beiden Kategorien dann der jeweilige Median als weitere Schwelle eingeführt wurde. Damit blieb die visuelle Vergleichbarkeit der Karten noch einigermassen erhalten, bei Beibehaltung des Akzents auf die Trennung von positiven und negativen Werten. Für detaillierte Vergleiche sind ja noch die jeweiligen Schwellen in der Legende verzeichnet bzw. auch die Daten in der Tabelle ersichtlich.

Beispielcode

Der Beispielcode steht im R-Repo dieses Blogs zum download bereit.

2014/07/06

Visualisierung von Wahlergebnissen mit Qt

Um die Möglichkeiten für die Entwicklung von Android Apps mit Qt zu testen, habe ich eine simple Anwendung zur Visualisierung von Wahlerbnissen erstellt. Das Projekt kann vom Visualisierungs-Beispiele Repositorium herunter geladen und auf Desktop oder neueren Android Versionen getestet werden.

Screenshot - Wahlergebnisse App

Wahlergbnisse der EU-Wahl 2014 in Steyr 

Da die Daten der letzten politischen Wahl in meiner Heimatstadt einfach zugänglich waren, habe ich diese als Datenbasis verwendet. Diese lagen schon aufbereitet durch die Abteilung für Wahlen der Kommunalverwaltungsbehörde vor und wurden lediglich in XML umgewandelt, um sie durch ein XMLListModel-Objekt in die Anwendung eingebinden zu können.

Tabellenansicht

Auf Basis eines Grid-Layouts wurde dann eine Tabelle mit den Ergebnissen erstellt. Diese ist flickable, mit einer Wischgeste kann also zu den Ergebnissen der Parteien der hinteren Listenplätze gescrollt werden. Auf mehr Interaktion wurde zu Gunsten der Simplizität verzichtet. Uninspirierter Weise wurden die Farben aus dem Standard-Farbschema von Android zur farblichen Gestaltung verwendet.

Fazit

Die Entwicklung einer Android App, die auch auf Desktops lauffähig ist, mit Qt war Dank der umfangreichen Dokumentation des Projekts einfach. Die Integration von tabellarischen Daten und Wiederverwendung in selber Form ist ebenso unkompliziert umzusetzen, wie ein grid-basiertes Layout zur Aufbereitung. Der erstellte Prototyp der App läuft auf Desktop- und neueren Android-Geräten und ist grundsätzlich mit weiteren Features erweiterbar. So wäre eine Navigation zu den einzelnen Stadtteilergebnissen ohne größere Mühen umsetzbar. Eine Darstellung in Diagrammform wäre ebenso denkbar wie sinnvoll, nur etwas umständlicher umzusetzen, da das Datenvisualisierungsmodul von Qt nicht in der OpenSource Version enthalten ist. 

2014/05/19

Befragungs-App mit QtQuick und Python

Nachdem ich in letzter Zeit ein wenig mit QtQuick herum gespielt habe, war es an der Zeit einen funktionierenden Prototypen zu erstellen. Ich entschied mich, eine simple Befragungs-App zu entwickeln, die auf Tablets oder Touchscreens zum Einsatz kommen könnte.

Interaktion QtQuick mit Python

Die Anwendung ist so aufgeteilt, dass der in QML geschriebene QtQuick Teil die User Interaktion übernimmt, Python die Anwendung beginnt (bzw. schließt) und die erhobenen Daten in eine Output-Datei prozessiert.
Grundsätzlich ist die Interaktion von QtQuick mit Python über PyQt- oder PySide-Bindungen möglich. Gut dokumentierte Beispiele finden sich dafür im Web. Ein noch derzeit vorhandenes Problem dabei ist jedoch, dass QtQuick 2 derzeit nur in PyQt5 (und auch noch nicht in PySide) implementiert ist. Problematisch deswegen, weil dies zu einer Einschränkung für die Entwicklung der Anwendung führte, da PyQt5 aktuell noch nicht auf meinem Fedora 20 System verfügbar ist, weswegen ich gezwungen war, auf PyQt4 zurückzugreifen. Das wiederum unterstützt jedoch nur Bindungen an QtQuick 1 Versionen. Im konkreten Fall ärgerlich, da die Einbindung von QtQuick in PyQt5 umgestellt wurde und in der aktuellen Version natürlicher funktioniert als mit dem PyQt4 QDeclarativeView.
Nichtsdestotrotz läuft die Anwendung so, dass über das Python Skript die App in einem Fenster gestartet wird. Danach übernimmt QtQuick und führt die Befragung durch. Daten werden nach jedem/r Befragten an die Python Anwendung geschickt. Diese übernimmt die Weiterverarbeitung und speichert die codierten Antworten in eine Output-Datei (zur erleichterten Prozessierung mit Statistik-Tools in eine CSV-Datei).

Layout

Da QML die Legung der einzelnen UI-Elemente in einem Grid-System begünstigt und flaches Design sowieso momentan wieder in Mode ist, habe ich mich für das Boxen-Layout als grafisches Paradigma entschieden. Dieses kommt auch dem möglichen Anwendungsfall auf mobilen Geräten mit Touch-Eingabe entgegen. 
Auch hier wieder eine Einschränkung durch den Umstand, nicht PyQt5 verwenden zu können. Mit QtQuick 2 und dem Modul Window 2.0 ist es unkompliziert möglich, auf die Breiten- und Höhenwerte des Displays zuzugreifen. Demnach kann das Layout mit ein wenig Aufwand so gelegt werden, dass es auf unterschiedlichen Ausgabegeräten sinnvoll dargestellt wird. Diesen Schritt habe ich bei meinem Prototypen ausgelassen, da mir eben der Zugriff auf das Modul nicht möglich war und der Mehraufwand für eine responsive Layoutlegung keinen Nuzten gebracht hätte. Demnach habe ich mich für eine fiktive Bildschirmauflösung von 1280 * 800 Pixel entschieden. Dies entspricht einigen älteren Tablets oder Laptop-Bildschirme, was für den Anwendungsfall einer mobilen Befragungsanwendung zumindest zu einem möglichen Einsatzsszenario passen würde.
Als Symbole werden Icons aus Font Awesome verwendet. Der Import von Zeichen aus dieser ikonografischen Schrift für Bootstrap ist sehr gut auf Marks's KDE Blog beschrieben. Als Schriftart für Textelemente wird Verdana eingesetzt.
Py_QML_Befrager: Item Selbstanbau

Thema "Selbstversorgung"

Da mein Fokus hier nicht auf den Inhalt der App lag, habe ich mich für einfache Beispiel-Items zum Thema "Selbstversorgung mit Nahrungsmittel in Oberösterreich" entschieden. Diese sind jedoch so gewählt, dass sie mit gängigen Antworttypen zusammen passen, die sinnvoll im Boxen-Layout verpackt werden können. Die ersten drei Items sind demnach Beispiele welche Bedeutung (Skala von sehr unwichtig bis sehr wichtig) und Wünschbarkeit (sehr unerwünscht bis sehr erwünscht) von bzw. Zustimmung (lehne stark ab bis stimme stark zu) zu Aussagen auf jeweils 5-stufigen Skalen messen. Die Items zu Gemeindegröße und Alter wurden mit Kategorien operationalisiert, um dem Boxen-Layout gerecht zu werden. Das Geschlecht wird dichotom erhoben, wobei eine weitere Box als Antwortalternative den verbreiteten Genderdeterminismus in der Operationalisierung dieses Items aufzuhehen versucht oder zumindest eine weitere Auswahlmöglichkeit bereit stellt.
Py_QML_Befrager: Item Geschlecht

Testen und Fazit

Wer selbst mit der App ein wenig herum spielen möchte, der Quellcode und Ressourcendateien sind im Python-Beispiele Repo für diesen Blog auf Github unter dem Verzeichnis "PyQML_Box_Befrager" abgelegt.
Als Fazit bleibt, dass die Entwicklung von sozialwisschenschaftlich relevanten Anwendungen mit QtQuick und Python möglich ist. Zu hoffen bleibt diesbezüglich, dass die Verbreitung von PyQt5 demnächst weiter zunimmt. Das Boxen-Layout limiert zwar die Itemausgestaltung, hat jedoch auf mobilen Geräten wiederum seine Vorteile.